
Retrouvez ici la version Podcast :
LES CONTEXTE & LES ENJEUX
Cette question devenue centrale pour les exploitants de salles informatiques et de Data Centers
Dans un environnement IT critique, une intervention humaine peut sembler banale : Remplacer un serveur, déplacer une baie, débrancher un cordon, intervenir sous plancher, effectuer une maintenance, modifier un raccordement électrique ou intervenir sur un équipement de refroidissement.
Pourtant, plus les infrastructures deviennent complexes, denses, interconnectées et sollicitées, plus le risque lié au geste humain devient un véritable enjeu de disponibilité et de résilience.
La bonne question n’est donc plus seulement : « Comment éviter que les techniciens fassent des erreurs ? »
Elle devrait être :
Comment concevoir l’organisation, les procédures, l’environnement de travail et les moyens techniques pour rendre l’erreur moins probable, plus facilement détectable et surtout moins critique ?
5 points à retenir :
- 1°) Les Data Centers sont aujourd’hui confrontés à une complexification rapide des infrastructures, notamment avec les contraintes énergétiques, la densification des équipements et l’apparition du refroidissement liquide, qui multiplient les interactions entre infrastructures IT, électriques, hydrauliques et thermiques.
- 2°) Dans ce contexte, l’erreur humaine ne disparaît pas avec l’automatisation : Elle peut simplement se déplacer vers de nouvelles étapes du processus, notamment la préparation, la configuration, l’autorisation ou la supervision des opérations.
- 3°) Les données de l’Uptime Institute montrent que, pour 2026, le non-respect des procédures reste le principal facteur des incidents liés à l’erreur humaine, devant notamment les processus inadéquats et les erreurs d’installation ou d’intervention.
- 4°) L’erreur humaine est par ailleurs rarement une simple « erreur du technicien » : Elle peut résulter d’une procédure trop complexe, d’un manque de formation, d’une mauvaise identification, d’un environnement de travail peu ergonomique, de la fatigue ou d’une organisation insuffisamment structurée.
- 5°) Ne pas traiter ce risque expose donc l’exploitant à des interruptions de service, des dommages matériels, des opérations de maintenance prolongées, des reprises d’intervention, des risques électriques ou physiques, des pertes financières et une dégradation de la confiance des utilisateurs.
LES BONNES PRATIQUES & NOS CONSEILS
La réduction du risque humain repose aujourd’hui moins sur la recherche du « zéro erreur » que sur la mise en place d’un système d’exploitation capable de prévenir, détecter et absorber les erreurs.
Voici donc une approche simple en 10 points à systématiser pour tenter d’apporter ceinture, bretelle et airbag à vos opérations en salle :
1. Standardiser les interventions critiques
Toute intervention susceptible d’affecter la disponibilité devrait être associée à une procédure formalisée : objectif, périmètre, prérequis, identification des équipements, séquence des opérations, points d’arrêt, contrôles et conditions de retour arrière.
2. Faire précéder le geste d’une préparation
La règle essentielle est simple : Préparer avant d’intervenir.
La documentation, les plans, les références des équipements, les chemins de câbles, les configurations et les autorisations doivent être vérifiés avant l’entrée en salle.
Et pourquoi même ne pas « faire répéter » l’opération « à blanc » par le(s) technicien(s) impliqué(s) dans une zone neutre ou à faible risque.
3. Identifier sans ambiguïté
L’identification physique des baies, équipements, ports, câbles, alimentations et circuits constitue une barrière essentielle contre l’erreur de manipulation.
Une intervention ne devrait jamais reposer sur la mémoire du technicien ou sur une identification « visuelle approximative ».
4. Introduire le principe du « read-back »
Pour les opérations critiques, l’opérateur vérifie et fait confirmer l’identification avant d’agir : « Je vais intervenir sur X, raccordé à Y, conformément à la procédure Z. »
Cette pratique, issue notamment des environnements à forte criticité, réduit le risque de mauvaise interprétation.
5. Séparer préparation, autorisation et exécution
Pour les opérations les plus sensibles, la séparation des rôles constitue une barrière supplémentaire : une personne prépare, une autre contrôle et autorise, puis l’opérateur exécute.
Le principe de séparation des tâches fait notamment partie des contrôles de sécurité documentés par le NIST (National Institute of Standards & Technologies) Cf. lien dédié ci dessous dans la rubrique référentiels.
6. Concevoir des procédures réellement utilisables
Une procédure de 50 pages que personne ne consulte au moment critique ne constitue pas nécessairement une bonne procédure.
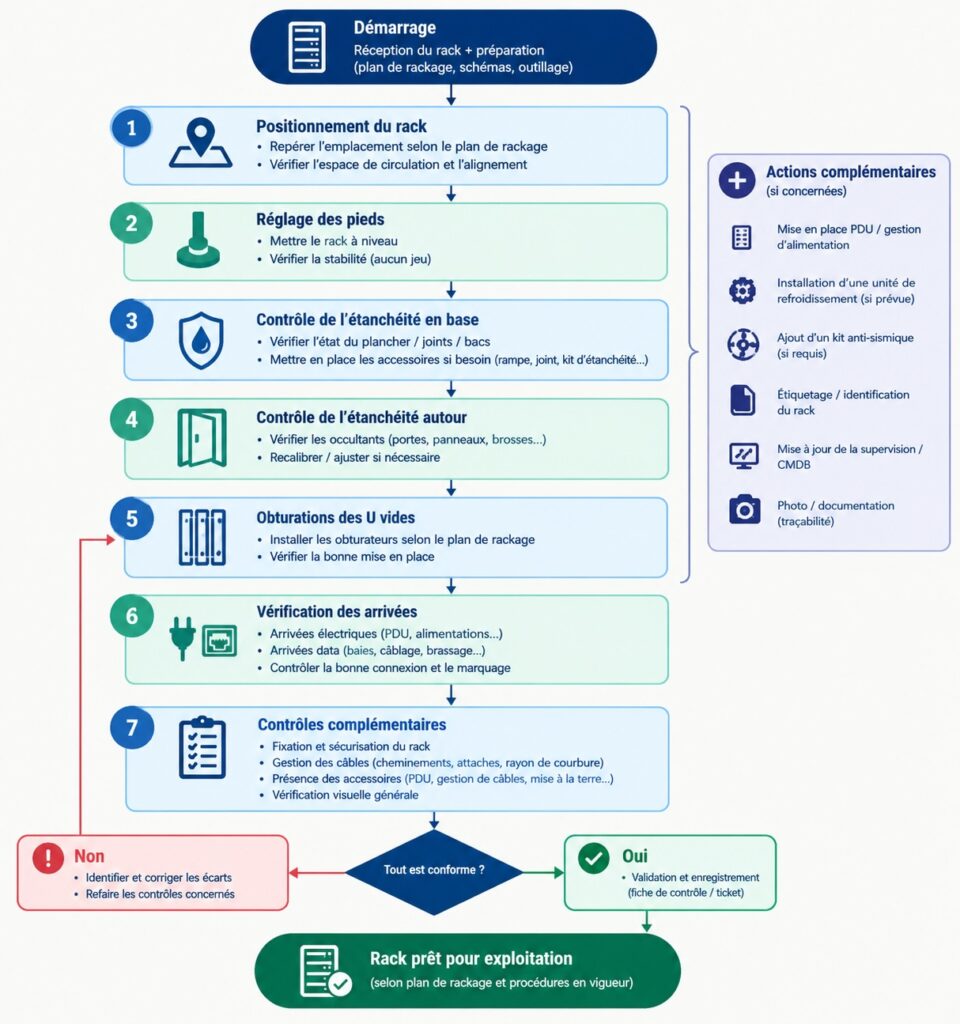
L’Uptime Institute souligne notamment que les procédures d’urgence peuvent être trop vagues, trop détaillées, difficiles à suivre ou mal présentées. Leur conception doit donc tenir compte des capacités cognitives de l’opérateur en position d’intervention (environnement inconfortable, bruyant, concentration difficile, …). Son format doit être déclinable sur des supports pratiques pour l’accompagenr en salle (classeur, tablette tactile, feuillet plastifié, …) et du contexte réel d’intervention et se présenter si possible sous forme visuelle et concrète type arbre de décision, logigramme …
En voici un exemple type :
7. Former régulièrement les intervenants
La compétence ne doit pas être considérée comme définitivement acquise.
Les changements d’architecture, nouveaux équipements, nouveaux modes de refroidissement, nouvelles procédures et nouvelles organisations nécessitent des remises à niveau régulières et des exercices pratiques.
8. Réduire la durée et la pénibilité des interventions
La fatigue et les conditions physiques de travail constituent des facteurs de risque. L’Uptime Institute souligne notamment le lien entre durée des postes, fatigue et probabilité d’erreur (Cf. lien dédié ci dessous dans la rubrique référentiels.)
Ergonomie, éclairage, accessibilité des équipements, moyens de levage et postes de travail adaptés participent donc directement à la fiabilité opérationnelle.
9. Contrôler après intervention
Une intervention ne devrait jamais se terminer au moment où le technicien retire son outil.
Il faut vérifier : état de l’équipement, connectivité, alimentation, alarmes, température, configuration, fermeture des accès, remise en état de la zone et traçabilité de l’opération.
10. Transformer chaque incident ou presque-incident en retour d’expérience
L’objectif n’est pas de rechercher un responsable mais de comprendre pourquoi le système a permis que l’erreur se produise.
Cette approche permet d’améliorer progressivement les procédures, les formations, l’organisation et les moyens matériels.
Ce que montrent les retours d’expérience
Les données Uptime Institute sont particulièrement instructives.
Dans son analyse 2024, l’organisme identifiait notamment comme causes majeures des incidents liés à l’erreur humaine : le non-respect des procédures, les procédures/processus incorrects, les erreurs d’installation et les erreurs lors des interventions en exploitation.
L’analyse 2025 indiquait par ailleurs que près de 40 % des organisations interrogées avaient subi une panne majeure liée à l’erreur humaine au cours des trois années précédentes et que 85 % de ces incidents étaient liés au non-respect des procédures ou à des défauts des processus/procédures.
En 2026, l’Uptime Institute constate que le non-respect des procédures reste le premier facteur des pannes liées à l’erreur humaine.
Le retour d’expérience est donc assez clair :
Former davantage ne suffit pas.
Il faut agir simultanément sur : COMPÉTENCES + PROCÉDURES + ORGANISATION + IDENTIFICATION + ERGONOMIE + OUTILLAGE + CONTRÔLE + RETOUR D’EXPÉRIENCE.
En conclusion : Ne cherchez pas à supprimer l’erreur humaine, rendez-la moins impactante
Dans un Data Center, l’erreur humaine est inévitable.
Ce qui ne devrait pas être inévitable, c’est qu’une erreur humaine puisse à elle seule provoquer une interruption majeure.
La stratégie moderne consiste donc à multiplier les barrières de sécurité opérationnelles :
1. Identifier
→ savoir précisément sur quel équipement intervenir.
2. Préparer
→ disposer de la documentation et des prérequis nécessaires.
3. Autoriser
→ vérifier que l’intervention peut effectivement être réalisée.
4. Exécuter
→ suivre une procédure claire, réaliste et adaptée.
5. Contrôler
→ vérifier le résultat avant de considérer l’intervention comme terminée.
6. Tracer
→ conserver l’historique de ce qui a été fait.
7. Capitaliser
→ transformer chaque incident, erreur ou presque-incident en amélioration.
C’est précisément là que l’exploitation d’un Data Center rejoint les principes de résilience, de gestion des risques et d’amélioration continue.
La meilleure intervention n’est pas celle réalisée par un technicien qui ne se trompe jamais.
C’est celle réalisée dans un système qui lui permet de ne pas se tromper — et qui empêche son erreur de devenir un incident majeur.
Pour un exploitant, la question n’est donc plus seulement :
« Mes équipes sont-elles compétentes ? »
Mais plutôt :
« Ai-je construit un environnement d’exploitation qui leur permet de réussir, systématiquement et en toute sécurité ? »
LES RÉFÉRENTIELS & RESSOURCES UTILES
ISO/IEC 20000-1 – Management des services IT
La norme fournit un cadre de management permettant de planifier, délivrer, surveiller et améliorer les services IT. Elle est particulièrement pertinente pour structurer les processus d’exploitation, de maintenance et d’amélioration continue.
ISO/IEC 20000-1 – fiche officielle ISO
Guide pratique ISO/IEC 20000
L’ISO propose également un guide pratique consacré au management des services IT et à l’articulation avec ITIL, Lean, DevOps, ISO 9001, ISO/IEC 27001 et ISO 31000.
ISO/IEC 20000 IT service management – A practical guide
NIST SP 800-53 – Separation of Duties / Least Privilege
Le référentiel NIST apporte notamment des principes utiles autour de la séparation des responsabilités, de la gestion des accès et de la limitation des privilèges.
Uptime Institute – Annual Outage Analysis 2026
L’étude la plus récente analyse les causes, la fréquence et les conséquences des interruptions IT et Data Center et confirme que la maîtrise des procédures et des opérations humaines reste un enjeu majeur.
Uptime Institute – Annual Outage Analysis 2026
Uptime Institute – Outages: understanding the human factor
Un article de référence consacré spécifiquement au facteur humain dans les interruptions de Data Centers.
Uptime Institute – Outages: understanding the human factor
Uptime Institute – Effective EOPs: how cognitive science can help
Une ressource particulièrement intéressante sur la conception des procédures opérationnelles d’urgence et leur utilisation réelle par les équipes.
Uptime Institute – Effective EOPs
Uptime Institute – Long shifts in data centers
Une ressource consacrée au lien entre fatigue, durée des postes et risque d’erreur humaine.
Uptime Institute – Long shifts in data centers
LES A.M.E. D’ODC => NOS RÉPONSES POUR BIEN DÉMARRER

Produits recommandés
-
Formation aux Principes de management des opérations du DC
-

Contrat A.M.E©
-
Diagnostic d’exploitation
-
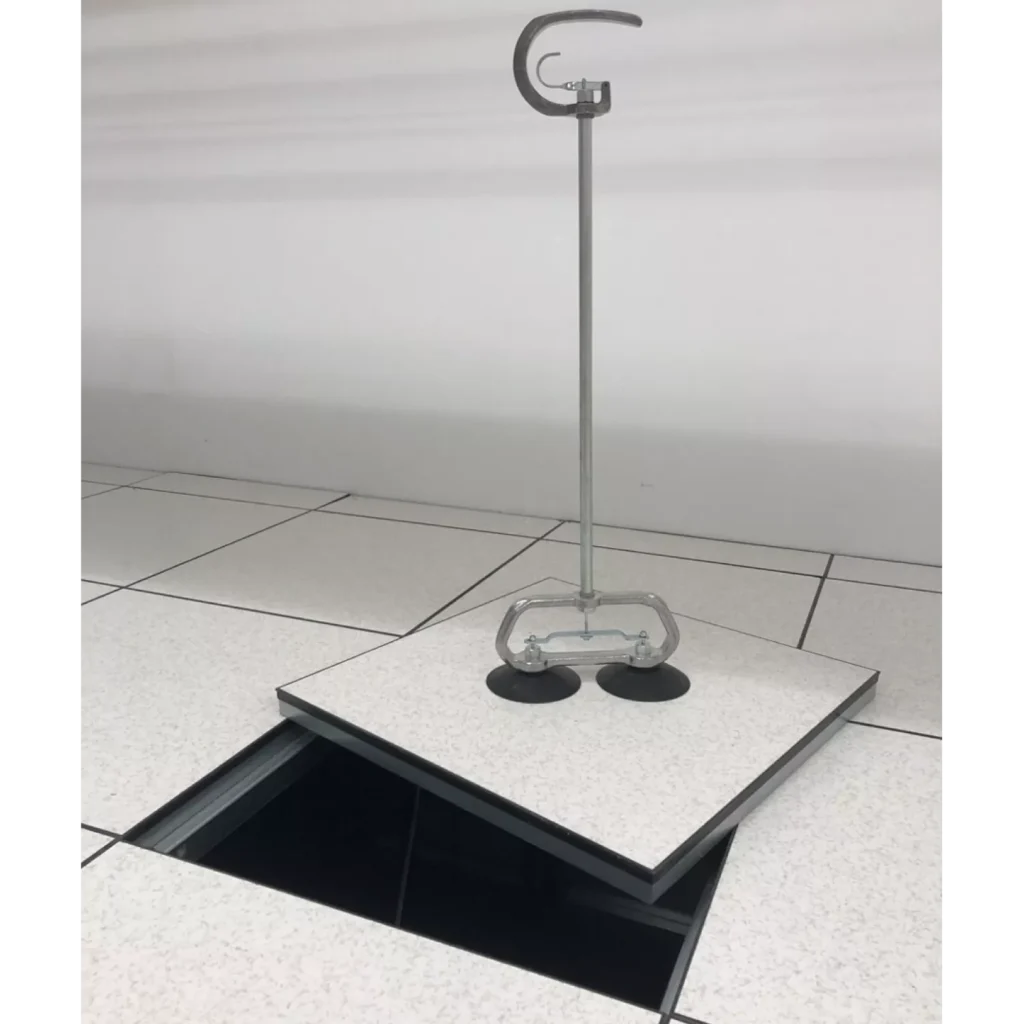
Ventouse Stressless
-
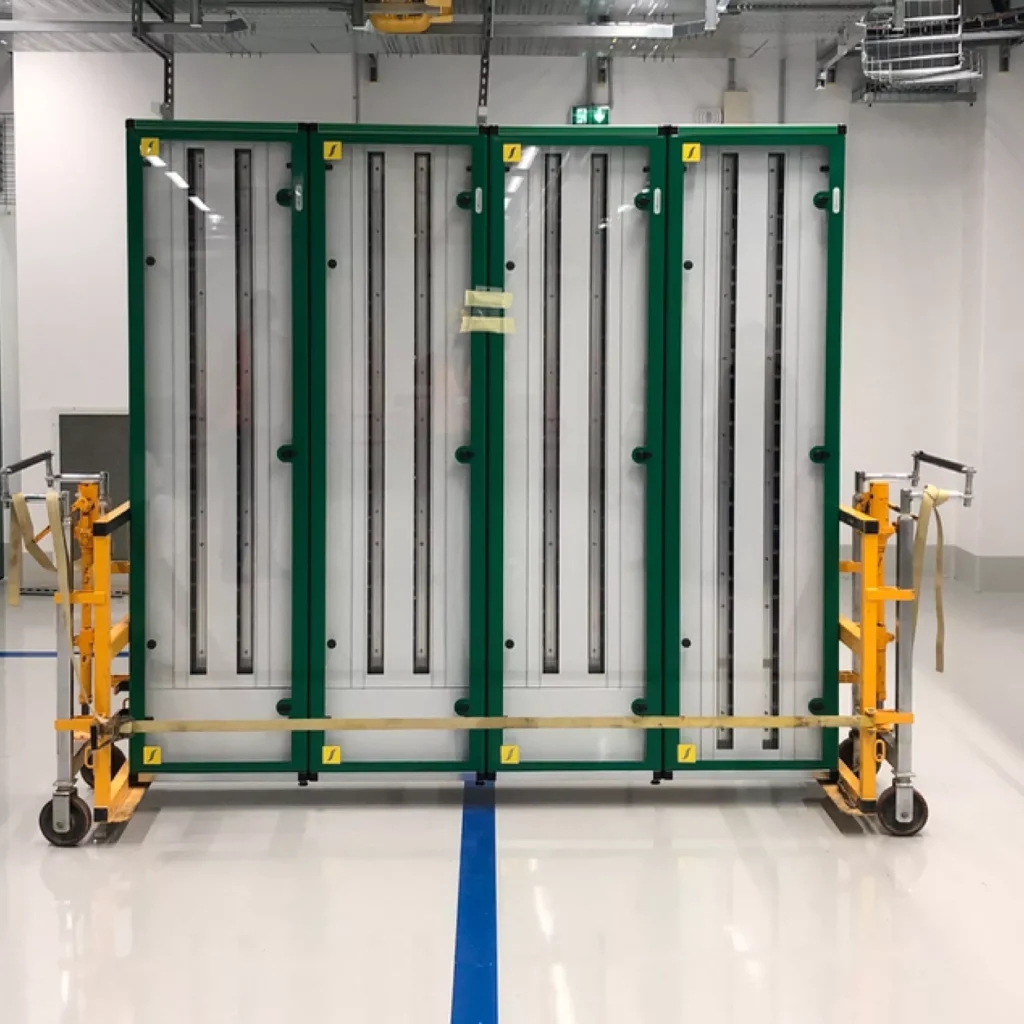
Chariot de levage pour équipements lourds
-
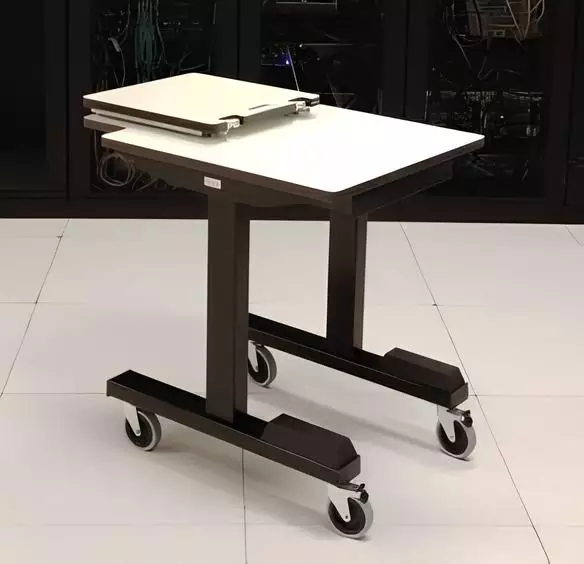
Chariot porte-serveur
-
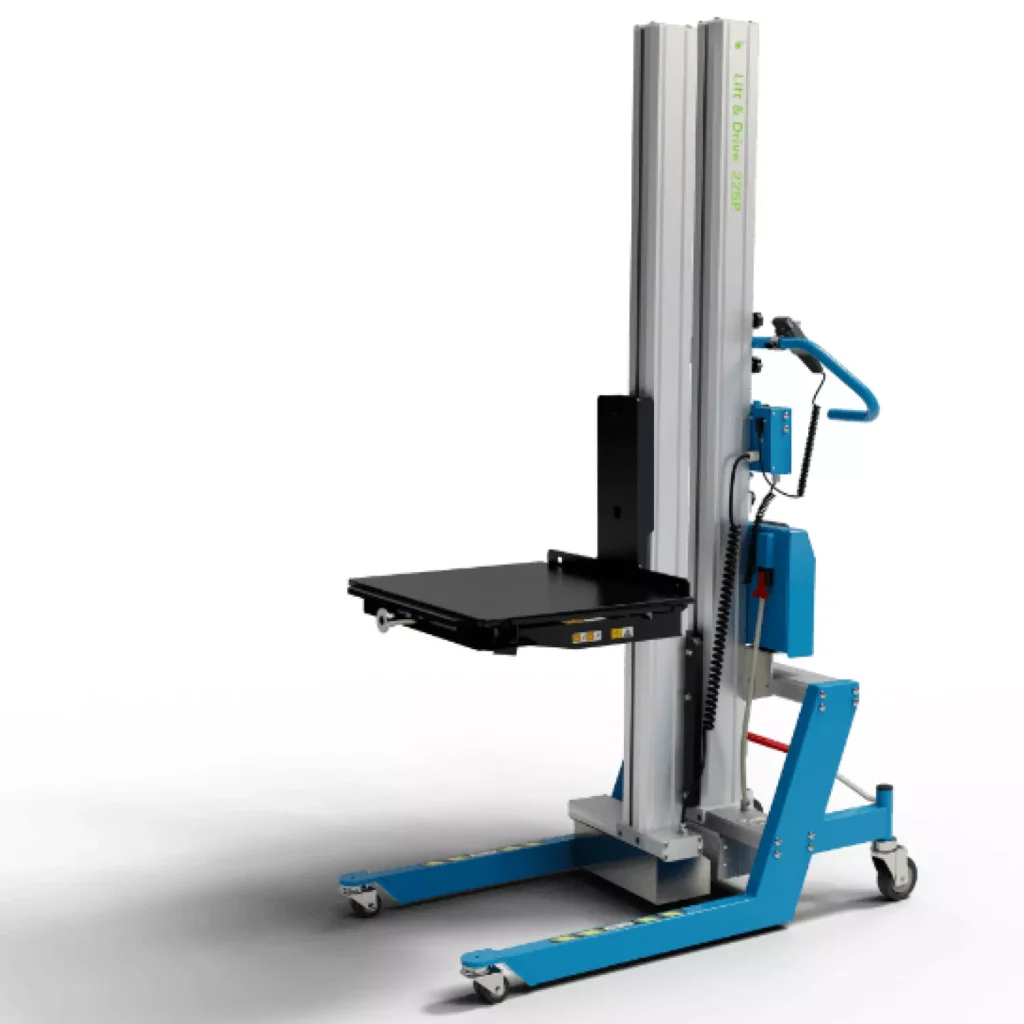
Chariot ergonomique motorisé pour Data Center
-
Chariot mobile pour déplacement des supports de stockage
-
Balisage et accessoires de sécurité